Kubernetes - ELK 日志管理
ELK 组成
Elasticsearch
ES 作为一个搜索型文档数据库,拥有优秀的搜索能力,以及提供了丰富的 REST API 让我们可以轻松的调用接口。
Filebeat
Filebeat 是一款轻量的数据收集工具。
Logstash
通过 Logstash 同样可以进行日志收集,但是若每一个节点都需要收集时,部署 Logstash 有点过重,因此这里主要用到 Logstash 的数据清洗能力,收集交给 Filebeat 去实现。
Kibana
Kibana 是一款基于 ES 的可视化操作界面工具,利用 Kibana 可以实现非常方便的 ES 可视化操作。
流程图
k8s 内置 Docker,而 Docker 专门有个所有容器的统一日志收集目录 /var/log/containers,所以可以用 Filebeat 去这个目录收集容器的日志,收集后发给 Logstash(如果日志数据太大,可以先发给 Kafka 等中间件,然后 Logstash 去 Kafka 获取日志)。
Logstash 得到日志后,内部可以进行数据的清洗等操作,然后发给 ElasticSearch,接着 Kibana 通过 ElasticSearch 的 API 去 ElasticSearch 里检索日志,在页面展示给程序员、运维人员看。
Kibana 是一个 ElasticSearch 的可视化界面
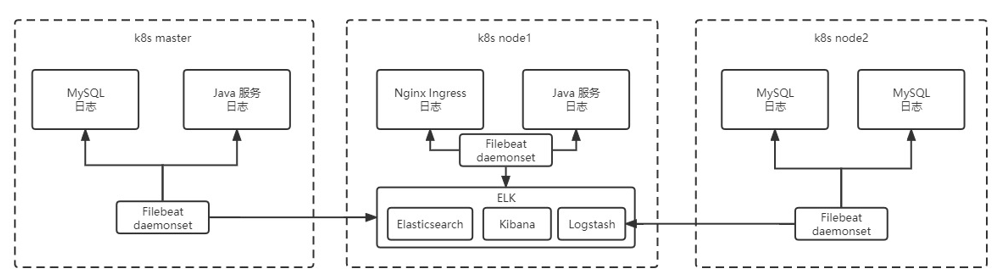
如下图:
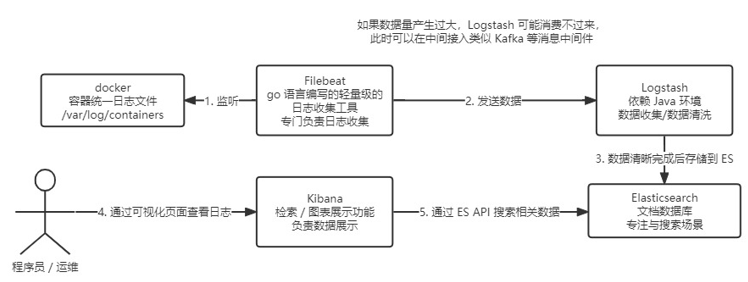
集成 ELK
部署 es 搜索服务
需要提前给 es 落盘节点打上标签
# 对应下面 es.yaml 的 127
kubectl label node <node name> es=data创建 es.yaml
---
apiVersion: v1
kind: Service
metadata:
  name: elasticsearch-logging
  namespace: kube-logging
  labels:
    k8s-app: elasticsearch-logging
    kubernetes.io/cluster-service: "true"
    addonmanager.kubernetes.io/mode: Reconcile
    kubernetes.io/name: "Elasticsearch"
spec:
  ports:
    - port: 9200
      protocol: TCP
      targetPort: db
  selector:
    k8s-app: elasticsearch-logging
---
# RBAC authn and authz
apiVersion: v1
kind: ServiceAccount
metadata:
  name: elasticsearch-logging
  namespace: kube-logging
  labels:
    k8s-app: elasticsearch-logging
    kubernetes.io/cluster-service: "true"
    addonmanager.kubernetes.io/mode: Reconcile
---
kind: ClusterRole
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  name: elasticsearch-logging
  labels:
    k8s-app: elasticsearch-logging
    kubernetes.io/cluster-service: "true"
    addonmanager.kubernetes.io/mode: Reconcile
rules:
  - apiGroups:
      - ""
    resources:
      - "services"
      - "namespaces"
      - "endpoints"
    verbs:
      - "get"
---
kind: ClusterRoleBinding
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  namespace: kube-logging
  name: elasticsearch-logging
  labels:
    k8s-app: elasticsearch-logging
    kubernetes.io/cluster-service: "true"
    addonmanager.kubernetes.io/mode: Reconcile
subjects:
  - kind: ServiceAccount
    name: elasticsearch-logging
    namespace: kube-logging
    apiGroup: ""
roleRef:
  kind: ClusterRole
  name: elasticsearch-logging
  apiGroup: ""
---
# Elasticsearch deployment itself
apiVersion: apps/v1
kind: StatefulSet # 使用 statefulset 创建 Pod
metadata:
  name: elasticsearch-logging # pod 名称,使用 statefulSet 创建的 Pod 是有序号有顺序的
  namespace: kube-logging # 命名空间
  labels:
    k8s-app: elasticsearch-logging
    kubernetes.io/cluster-service: "true"
    addonmanager.kubernetes.io/mode: Reconcile
    srv: srv-elasticsearch
spec:
  serviceName: elasticsearch-logging # 与 svc 相关联,这可以确保使用以下 DNS 地址访问 Statefulset 中的每个 pod (es-cluster-[0,1,2].elasticsearch.elk.svc.cluster.local)
  replicas: 1 # 副本数量,单节点
  selector:
    matchLabels:
      k8s-app: elasticsearch-logging # 和 pod template 配置的 labels 相匹配
  template:
    metadata:
      labels:
        k8s-app: elasticsearch-logging
        kubernetes.io/cluster-service: "true"
    spec:
      serviceAccountName: elasticsearch-logging
      containers:
        - image: docker.io/library/elasticsearch:7.9.3
          name: elasticsearch-logging
          resources:
            # need more cpu upon initialization, therefore burstable class
            limits:
              cpu: 1000m
              memory: 2Gi
            requests:
              cpu: 100m
              memory: 500Mi
          ports:
            - containerPort: 9200
              name: db
              protocol: TCP
            - containerPort: 9300
              name: transport
              protocol: TCP
          volumeMounts:
            - name: elasticsearch-logging
              mountPath: /usr/share/elasticsearch/data/ # 挂载点
          env:
            - name: "NAMESPACE"
              valueFrom:
                fieldRef:
                  fieldPath: metadata.namespace
            - name: "discovery.type" # 定义单节点类型
              value: "single-node"
            - name: ES_JAVA_OPTS # 设置 Java 的内存参数,可以适当进行加大调整
              value: "-Xms512m -Xmx2g"
      volumes:
        - name: elasticsearch-logging
          hostPath:
            path: /data/es/
      nodeSelector: # 如果需要匹配落盘节点可以添加 nodeSelect
        es: data
      tolerations:
        - effect: NoSchedule
          operator: Exists
      # Elasticsearch requires vm.max_map_count to be at least 262144.
      # If your OS already sets up this number to a higher value, feel free
      # to remove this init container.
      initContainers: # 容器初始化前的操作
        - name: elasticsearch-logging-init
          image: alpine:3.6
          command: ["/sbin/sysctl", "-w", "vm.max_map_count=262144"] # 添加 mmap 计数限制,太低可能造成内存不足的错误
          securityContext: # 仅应用到指定的容器上,并且不会影响 Volume
            privileged: true # 运行特权容器
        - name: increase-fd-ulimit
          image: busybox
          imagePullPolicy: IfNotPresent
          command: ["sh", "-c", "ulimit -n 65536"] # 修改文件描述符最大数量
          securityContext:
            privileged: true
        - name: elasticsearch-volume-init # es 数据落盘初始化,加上 777 权限
          image: alpine:3.6
          command:
            - chmod
            - -R
            - "777"
            - /usr/share/elasticsearch/data/
          volumeMounts:
            - name: elasticsearch-logging
mountPath: /usr/share/elasticsearch/data/创建命名空间
kubectl create ns kube-logging创建服务
kubectl create -f es.yaml查看 pod 启用情况
kubectl get pod -n kube-logging部署 logstash 数据清洗
创建 logstash.yaml 并部署服务
---
apiVersion: v1
kind: Service
metadata:
  name: logstash
  namespace: kube-logging
spec:
  ports:
    - port: 5044
      targetPort: beats
  selector:
    type: logstash
  clusterIP: None
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: logstash
  namespace: kube-logging
spec:
  selector:
    matchLabels:
      type: logstash
  template:
    metadata:
      labels:
        type: logstash
        srv: srv-logstash
    spec:
      containers:
        - image: docker.io/kubeimages/logstash:7.9.3 # 该镜像支持 arm64 和 amd64 两种架构
          name: logstash
          ports:
            - containerPort: 5044
              name: beats
          command:
            - logstash
            - "-f"
            - "/etc/logstash_c/logstash.conf"
          env:
            - name: "XPACK_MONITORING_ELASTICSEARCH_HOSTS"
              value: "http://elasticsearch-logging:9200"
          volumeMounts:
            - name: config-volume
              mountPath: /etc/logstash_c/
            - name: config-yml-volume
              mountPath: /usr/share/logstash/config/
            - name: timezone
              mountPath: /etc/localtime
          resources: # logstash 一定要加上资源限制,避免对其他业务造成资源抢占影响
            limits:
              cpu: 1000m
              memory: 2048Mi
            requests:
              cpu: 512m
              memory: 512Mi
      volumes:
        - name: config-volume
          configMap:
            name: logstash-conf
            items:
              - key: logstash.conf
                path: logstash.conf
        - name: timezone
          hostPath:
            path: /etc/localtime
        - name: config-yml-volume
          configMap:
            name: logstash-yml
            items:
              - key: logstash.yml
                path: logstash.yml

---
apiVersion: v1
kind: ConfigMap
metadata:
  name: logstash-conf
  namespace: kube-logging
  labels:
    type: logstash
data:
  logstash.conf: |-
    input {
      beats {
        port => 5044
      }
    }
    filter {
      # 处理 ingress 日志
      if [kubernetes][container][name] == "nginx-ingress-controller" {
        json {
          source => "message"
          target => "ingress_log"
        }
        if [ingress_log][requesttime] {
          mutate {
            convert => ["[ingress_log][requesttime]", "float"]
          }
        }
        if [ingress_log][upstremtime] {
          mutate {
            convert => ["[ingress_log][upstremtime]", "float"]
          }
        }
        if [ingress_log][status] {
          mutate {
            convert => ["[ingress_log][status]", "float"]
          }
        }
        if  [ingress_log][httphost] and [ingress_log][uri] {
          mutate {
            add_field => {"[ingress_log][entry]" => "%{[ingress_log][httphost]}%{[ingress_log][uri]}"}
          }
          mutate {
            split => ["[ingress_log][entry]","/"]
          }
          if [ingress_log][entry][1] {
            mutate {
              add_field => {"[ingress_log][entrypoint]" => "%{[ingress_log][entry][0]}/%{[ingress_log][entry][1]}"}
              remove_field => "[ingress_log][entry]"
            }
          } else {
            mutate {
              add_field => {"[ingress_log][entrypoint]" => "%{[ingress_log][entry][0]}/"}
              remove_field => "[ingress_log][entry]"
            }
          }
        }
      }
      # 处理以srv进行开头的业务服务日志
      if [kubernetes][container][name] =~ /^srv*/ {
        json {
          source => "message"
          target => "tmp"
        }
        if [kubernetes][namespace] == "kube-logging" {
          drop{}
        }
        if [tmp][level] {
          mutate{
            add_field => {"[applog][level]" => "%{[tmp][level]}"}
          }
          if [applog][level] == "debug"{
            drop{}
          }
        }
        if [tmp][msg] {
          mutate {
            add_field => {"[applog][msg]" => "%{[tmp][msg]}"}
          }
        }
        if [tmp][func] {
          mutate {
            add_field => {"[applog][func]" => "%{[tmp][func]}"}
          }
        }
        if [tmp][cost]{
          if "ms" in [tmp][cost] {
            mutate {
              split => ["[tmp][cost]","m"]
              add_field => {"[applog][cost]" => "%{[tmp][cost][0]}"}
              convert => ["[applog][cost]", "float"]
            }
          } else {
            mutate {
              add_field => {"[applog][cost]" => "%{[tmp][cost]}"}
            }
          }
        }
        if [tmp][method] {
          mutate {
            add_field => {"[applog][method]" => "%{[tmp][method]}"}
          }
        }
        if [tmp][request_url] {
          mutate {
            add_field => {"[applog][request_url]" => "%{[tmp][request_url]}"}
          }
        }
        if [tmp][meta._id] {
          mutate {
            add_field => {"[applog][traceId]" => "%{[tmp][meta._id]}"}
          }
        }
        if [tmp][project] {
          mutate {
            add_field => {"[applog][project]" => "%{[tmp][project]}"}
          }
        }
        if [tmp][time] {
          mutate {
            add_field => {"[applog][time]" => "%{[tmp][time]}"}
          }
        }
        if [tmp][status] {
          mutate {
            add_field => {"[applog][status]" => "%{[tmp][status]}"}
            convert => ["[applog][status]", "float"]
          }
        }
      }
      mutate {
        rename => ["kubernetes", "k8s"]
        remove_field => "beat"
        remove_field => "tmp"
        remove_field => "[k8s][labels][app]"
      }
    }
    output {
      elasticsearch {
        hosts => ["http://elasticsearch-logging:9200"]
        codec => json
        index => "logstash-%{+YYYY.MM.dd}" # 索引名称以 logstash+ 日志进行每日新建
      }
    }
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: logstash-yml
  namespace: kube-logging
  labels:
    type: logstash
data:
  logstash.yml: |-
    http.host: "0.0.0.0"
xpack.monitoring.elasticsearch.hosts: http://elasticsearch-logging:9200kubectl create -f logstash.yaml部署 filebeat 数据采集
创建 filebeat.yaml 并部署
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: filebeat-config
  namespace: kube-logging
  labels:
    k8s-app: filebeat
data:
  filebeat.yml: |-
    filebeat.inputs:
    - type: container
      enable: true
      paths:
        - /var/log/containers/*.log # 这里是 filebeat 采集挂载到 pod 中的日志目录
      processors:
        - add_kubernetes_metadata: # 添加 k8s 的字段用于后续的数据清洗
            host: ${NODE_NAME}
            matchers:
            - logs_path:
                logs_path: "/var/log/containers/"
    # output.kafka:  # 如果日志量较大,es 中的日志有延迟,可以选择在 filebeat 和 logstash 中间加入 kafka
    #  hosts: ["kafka-log-01:9092", "kafka-log-02:9092", "kafka-log-03:9092"]
    # topic: 'topic-test-log'
    #  version: 2.0.0
    output.logstash: # 因为还需要部署 logstash 进行数据的清洗,因此 filebeat 是把数据推到 logstash 中
       hosts: ["logstash:5044"]
       enabled: true
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: filebeat
  namespace: kube-logging
  labels:
    k8s-app: filebeat
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: filebeat
  labels:
    k8s-app: filebeat
rules:
  - apiGroups: [""] # "" indicates the core API group
    resources:
      - namespaces
      - pods
    verbs: ["get", "watch", "list"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
  name: filebeat
subjects:
  - kind: ServiceAccount
    name: filebeat
    namespace: kube-logging
roleRef:
  kind: ClusterRole
  name: filebeat
  apiGroup: rbac.authorization.k8s.io
---
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: filebeat
  namespace: kube-logging
  labels:
    k8s-app: filebeat
spec:
  selector:
    matchLabels:
      k8s-app: filebeat
  template:
    metadata:
      labels:
        k8s-app: filebeat
    spec:
      serviceAccountName: filebeat
      terminationGracePeriodSeconds: 30
      containers:
        - name: filebeat
          image: docker.io/kubeimages/filebeat:7.9.3 # 该镜像支持 arm64 和 amd64 两种架构
          args: ["-c", "/etc/filebeat.yml", "-e", "-httpprof", "0.0.0.0:6060"]
          #ports:
          #  - containerPort: 6060
          #    hostPort: 6068
          env:
            - name: NODE_NAME
              valueFrom:
                fieldRef:
                  fieldPath: spec.nodeName
            - name: ELASTICSEARCH_HOST
              value: elasticsearch-logging
            - name: ELASTICSEARCH_PORT
              value: "9200"
          securityContext:
            runAsUser: 0
            # If using Red Hat OpenShift uncomment this:
            #privileged: true
          resources:
            limits:
              memory: 1000Mi
              cpu: 1000m
            requests:
              memory: 100Mi
              cpu: 100m
          volumeMounts:
            - name: config # 挂载的是 filebeat 的配置文件
              mountPath: /etc/filebeat.yml
              readOnly: true
              subPath: filebeat.yml
            - name: data # 持久化 filebeat 数据到宿主机上
              mountPath: /usr/share/filebeat/data
            - name: varlibdockercontainers # 这里主要是把宿主机上的源日志目录挂载到filebeat容器中,如果没有修改 docker 或者 containerd 的 runtime 进行了标准的日志落盘路径,可以把 mountPath 改为 /var/lib
              mountPath: /var/lib
              readOnly: true
            - name: varlog # 这里主要是把宿主机上 /var/log/pods和/var/log/containers 的软链接挂载到 filebeat 容器中
              mountPath: /var/log/
              readOnly: true
            - name: timezone
              mountPath: /etc/localtime
      volumes:
        - name: config
          configMap:
            defaultMode: 0600
            name: filebeat-config
        - name: varlibdockercontainers
          hostPath: # 如果没有修改docker或者containerd的runtime进行了标准的日志落盘路径,可以把path改为/var/lib
            path: /var/lib
        - name: varlog
          hostPath:
            path: /var/log/
        # data folder stores a registry of read status for all files, so we don't send everything again on a Filebeat pod restart
        - name: inputs
          configMap:
            defaultMode: 0600
            name: filebeat-inputs
        - name: data
          hostPath:
            path: /data/filebeat-data
            type: DirectoryOrCreate
        - name: timezone
          hostPath:
            path: /etc/localtime
      tolerations: #加入容忍能够调度到每一个节点
        - effect: NoExecute
          key: dedicated
          operator: Equal
          value: gpu
        - effect: NoSchedule
operator: Existskubectl create -f filebeat.yaml部署 kibana 可视化界面
此处有配置 kibana 访问域名,如果没有域名则需要在本机配置 hosts
192.168.199.28 kibana.youngkbt.cn创建 kibana.yaml 并创建服务
---
apiVersion: v1
kind: ConfigMap
metadata:
  namespace: kube-logging
  name: kibana-config
  labels:
    k8s-app: kibana
data:
  kibana.yml: |-
    server.name: kibana
    server.host: "0"
    i18n.locale: zh-CN                      # 设置默认语言为中文
    elasticsearch:
      hosts: ${ELASTICSEARCH_HOSTS}         # es 集群连接地址,由于我这都都是 k8s 部署且在一个 ns 下,可以直接使用 service name 连接
---
apiVersion: v1
kind: Service
metadata:
  name: kibana
  namespace: kube-logging
  labels:
    k8s-app: kibana
    kubernetes.io/cluster-service: "true"
    addonmanager.kubernetes.io/mode: Reconcile
    kubernetes.io/name: "Kibana"
    srv: srv-kibana
spec:
  type: NodePort
  ports:
    - port: 5601
      protocol: TCP
      targetPort: ui
  selector:
    k8s-app: kibana
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: kibana
  namespace: kube-logging
  labels:
    k8s-app: kibana
    kubernetes.io/cluster-service: "true"
    addonmanager.kubernetes.io/mode: Reconcile
    srv: srv-kibana
spec:
  replicas: 1
  selector:
    matchLabels:
      k8s-app: kibana
  template:
    metadata:
      labels:
        k8s-app: kibana
    spec:
      containers:
        - name: kibana
          image: docker.io/kubeimages/kibana:7.9.3 # 该镜像支持 arm64 和 amd64 两种架构
          resources:
            # need more cpu upon initialization, therefore burstable class
            limits:
              cpu: 1000m
            requests:
              cpu: 100m
          env:
            - name: ELASTICSEARCH_HOSTS
              value: http://elasticsearch-logging:9200
          ports:
            - containerPort: 5601
              name: ui
              protocol: TCP
          volumeMounts:
            - name: config
              mountPath: /usr/share/kibana/config/kibana.yml
              readOnly: true
              subPath: kibana.yml
      volumes:
        - name: config
          configMap:
            name: kibana-config
---
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: kibana
  namespace: kube-logging
spec:
  ingressClassName: nginx
  rules:
    - host: kibana.youngkbt.cn
      http:
        paths:
          - path: /
            pathType: Prefix
            backend:
              service:
                name: kibana
                port:
number: 5601kubectl create -f kibana.yamlKibana 配置
进入 Kibana 界面,打开菜单中的 Stack Management 可以看到采集到的日志。
避免日志越来越大,占用磁盘过多,进入 索引生命周期策略 界面点击 创建策略 按钮。
- 设置策略名称为
logstash-history-ilm-policy - 关闭热阶段
- 开启删除阶段,设置保留天数为 7 天
保存配置
为了方便在 discover 中查看日志,选择 索引模式 然后点击 创建索引模式 按钮。
索引模式名称 里面配置
logstash-*点击下一步
时间字段 选择
@timestamp点击 创建索引模式 按钮
由于部署的单节点,产生副本后索引状态会变成 yellow,打开 dev tools,取消所有索引的副本数
PUT _all/_settings
{
    "number_of_replicas": 0
}为了标准化日志中的 map 类型,以及解决链接索引生命周期策略,我们需要修改默认模板
PUT _template/logstash
{
    "order": 1,
    "index_patterns": [
      "logstash-*"
    ],
    "settings": {
      "index": {
      "lifecycle" : {
          "name" : "logstash-history-ilm-policy"
        },
        "number_of_shards": "2",
        "refresh_interval": "5s",
        "number_of_replicas" : "0"
      }
    },
    "mappings": {
        "properties": {
          "@timestamp": {
            "type": "date"
          },
          "applog": {
            "dynamic": true,
            "properties": {
              "cost": {
                "type": "float"
              },
              "func": {
                "type": "keyword"
              },
              "method": {
                "type": "keyword"
              }
            }
          },
          "k8s": {
            "dynamic": true,
            "properties": {
              "namespace": {
                "type": "keyword"
              },
              "container": {
                "dynamic": true,
                "properties": {
                  "name": {
                    "type": "keyword"
                  }
                }
              },
              "labels": {
                "dynamic": true,
                "properties": {
                  "srv": {
                    "type": "keyword"
                  }
                }
              }
            }
          },
          "geoip": {
            "dynamic": true,
            "properties": {
              "ip": {
                "type": "ip"
              },
              "latitude": {
                "type": "float"
              },
              "location": {
                "type": "geo_point"
              },
              "longitude": {
                "type": "float"
              }
            }
          }
      }
    },
    "aliases": {}
}最后即可通过 discover 进行搜索了。